Un pipeline CI/CD est la chaîne automatisée qui mène une modification de code jusqu'à la production : on intègre, on construit, on teste, puis on déploie, sans copier de fichiers à la main. Selon Red Hat, il fait avancer le code vers une version distribuable en couvrant la création, les tests, la mise en production et la surveillance. Cet article explique chaque étape, la différence entre intégration, livraison et déploiement continus, le déploiement bleu-vert, la gestion des versions et la sécurité du pipeline, avec un plan de démarrage réaliste pour une application d'entreprise.
En bref
- Un pipeline CI/CD automatise le trajet du code : déclenchement, build, tests, publication d'un artefact, préproduction, production, surveillance.
- Intégration continue : on fusionne souvent et on vérifie automatiquement. Livraison continue : la publication est automatisée, une approbation peut subsister. Déploiement continu : plus d'approbation, tout changement validé part en production.
- Le déploiement bleu-vert limite le risque d'une mise en production, au prix de deux environnements temporaires et d'une réflexion sur les données.
- Un pipeline détient du code et des accès de production : secrets, droits et dépendances se traitent dès le départ.
- Commencez petit : un projet pilote, du code versionné, quelques tests, puis enrichissez.
Table des matières
- À quoi sert un pipeline CI/CD
- Intégration, livraison et déploiement continus : trois notions distinctes
- Les étapes d'un pipeline, du commit à la production
- Déploiement bleu-vert : mettre en ligne sans coupure
- Release management : maîtriser les versions
- Intégrer tests, sécurité et validations
- Notre point de vue : le pipeline suit le projet, pas l'inverse
- Démarrer un pipeline CI/CD pas à pas
- Mettre en place un pipeline avec NGL Studio
- Questions fréquentes
- Sources
À quoi sert un pipeline CI/CD
Sans pipeline, une mise en ligne ressemble souvent à ceci : un développeur compile sur son poste, envoie des fichiers sur un serveur, vérifie quelques pages et croise les doigts. Chaque étape manuelle est une occasion d'oublier un test, une variable de configuration ou une migration.
Le pipeline remplace cette routine par un scénario écrit, rejoué à l'identique à chaque changement. D'après Red Hat, l'automatisation réduit les erreurs humaines et améliore en même temps la rapidité, la qualité et la sécurité des mises en production. Concrètement, vous y gagnez :
- des livraisons plus fréquentes et plus petites, donc plus faciles à comprendre et à corriger ;
- des défauts détectés tôt, quand ils coûtent peu à réparer ;
- une traçabilité : chaque version déployée correspond à un commit, à des tests et à un artefact identifiés ;
- moins de dépendance à une personne qui seule sait comment on déploie.
Pour une PME, une startup ou une association qui fait évoluer un outil métier, l'enjeu est moins la vitesse brute que la sérénité : pouvoir corriger un bug un mardi après-midi sans que personne ne redoute la mise en ligne.
Intégration, livraison et déploiement continus : trois notions distinctes
Le sigle CI/CD recouvre plusieurs pratiques. Le « CD » en particulier porte deux sens, ce qui crée beaucoup de confusion. Red Hat rappelle que CI signifie intégration continue, et que CD peut désigner la distribution continue ou le déploiement continu.
| Pratique | Ce qui est automatisé | Intervention humaine avant la production |
|---|---|---|
| Intégration continue | Fusion fréquente du code, build, vérifications de qualité | Revue de code avant fusion |
| Livraison continue | Publication vers un environnement de type production | Approbation possible avant la mise en production |
| Déploiement continu | Mise en production de tout changement validé | Aucune approbation |
Cette distinction suit la définition de la documentation d'architecture Microsoft : la livraison continue peut conserver une approbation, le déploiement continu la supprime. AWS formule la même frontière : approbation manuelle d'un côté, déploiement automatique sans approbation explicite de l'autre.
Quel niveau choisir ?
Le déploiement continu n'est pas un but en soi. Une application de gestion interne, utilisée par quarante personnes, gagne souvent à garder une validation humaine avant la production, par exemple après une démonstration en préproduction. Un site vitrine ou une application grand public avec une bonne couverture de tests peut au contraire se passer de cette étape. Le bon critère : le coût d'une erreur en production face au coût du délai d'une validation.
Les étapes d'un pipeline, du commit à la production
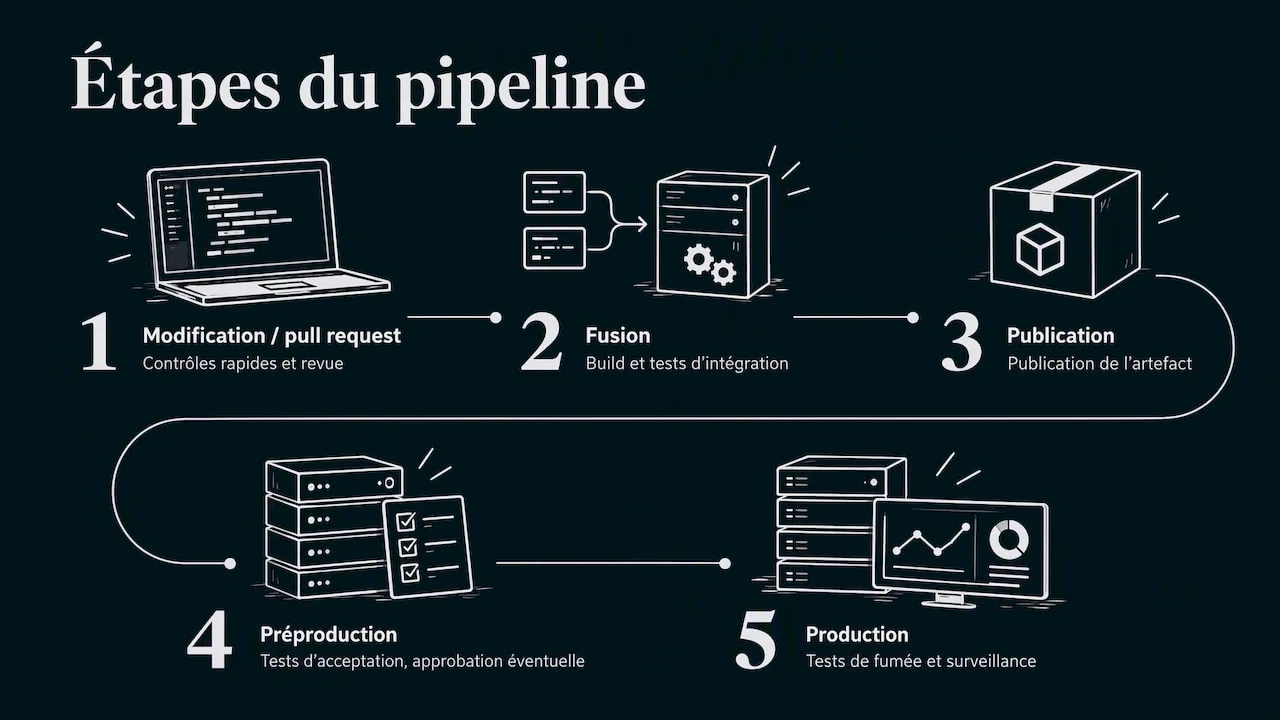
Les plateformes présentent des variantes, mais le parcours type est stable. La architecture de base d'Azure Pipelines le décrit ainsi : modification ou pull request, contrôles rapides et revue, fusion, build et tests d'intégration, publication d'un artefact, déploiement en préproduction, tests d'acceptation, approbation éventuelle, déploiement en production, tests de fumée et surveillance.
1. Le déclencheur
Un commit ou une pull request est le déclencheur le plus courant. GitLab précise qu'un pipeline peut aussi démarrer à la création d'un dépôt, manuellement, selon une planification ou à la fin d'un autre pipeline. La planification est utile pour des contrôles de sécurité nocturnes sur les dépendances.
2. Les contrôles rapides sur la pull request
Compilation, restauration des dépendances, linting, analyse statique, analyse de sécurité et tests unitaires s'exécutent avant toute fusion, avec une revue de code. Ces contrôles doivent durer quelques minutes : au-delà, les développeurs cessent d'attendre le résultat.
3. Build, tests d'intégration et artefact
Après la fusion, l'intégration continue reprend les contrôles précédents, ajoute les tests d'intégration et publie les artefacts de build, selon la même architecture de référence. Règle d'or : on construit une seule fois, et c'est le même artefact qui traverse tous les environnements. Reconstruire pour la production, c'est déployer autre chose que ce qu'on a testé.
4. Préproduction et tests d'acceptation
L'artefact est déployé dans un environnement aussi proche que possible de la production. On y rejoue les tests d'acceptation et, si besoin, un client ou un responsable métier valide manuellement. AWS note que l'infrastructure nécessaire est provisionnée à chaque étape (source, build, test, staging, production).
5. Production, tests de fumée et surveillance
Après la mise en production, quelques tests de fumée vérifient que les parcours vitaux répondent : connexion, paiement, création d'un enregistrement. La surveillance prend ensuite le relais, car un pipeline qui s'arrête au déploiement ne dit rien de la santé de l'application.
Déploiement bleu-vert : mettre en ligne sans coupure
Le déploiement bleu-vert est l'une des stratégies de mise en production les plus recherchées autour du CI/CD. Le principe : on déploie la nouvelle version à côté de l'ancienne, on la valide, puis on bascule le trafic. Dans sa documentation sur les microservices sur Kubernetes, Microsoft cite cette approche avec les sondes d'intégrité et les retours arrière automatisés.
Avantages
- la bascule est rapide et l'ancienne version reste disponible pour un retour arrière ;
- la nouvelle version est testée dans des conditions proches du réel avant de recevoir des utilisateurs ;
- pas de fenêtre de maintenance pour la plupart des changements.
Limites
- deux environnements coexistent un temps, ce qui a un coût d'infrastructure ;
- les migrations de base de données demandent une conception spécifique : les deux versions doivent supporter le même schéma pendant la transition, sinon le retour arrière devient illusoire.
En pratique, pour une application de taille moyenne, on adopte souvent la règle des migrations compatibles dans les deux sens : ajouter une colonne d'abord, l'utiliser ensuite, supprimer l'ancienne en dernier, sur trois livraisons distinctes. C'est moins spectaculaire qu'une bascule instantanée, mais c'est ce qui rend le bleu-vert réellement sûr.
Release management : maîtriser les versions
Le release management consiste à automatiser la gestion du pipeline de sortie des nouvelles versions et à en suivre l'avancement, comme le résume GitLab. Ce n'est pas qu'une affaire d'outil : c'est savoir à tout moment quelle version tourne où, et comment revenir en arrière.
Microsoft donne des recommandations très concrètes pour les conteneurs, dans la même documentation Kubernetes :
- déployer des balises de version précises plutôt que
latest; - séparer les images approuvées pour la production des autres ;
- conserver les images nécessaires aux déploiements actifs et aux retours arrière.
La même page indique que Helm versionne explicitement les graphiques, permet de visualiser les versions et de revenir à une version précédente, en s'appuyant sur le versionnage sémantique.
Le principe vaut au-delà des conteneurs. Microsoft explique que l'épinglage des versions donne des builds prévisibles, permet une adoption progressive, évite les changements inattendus et facilite le diagnostic. Un pipeline qui télécharge « la dernière version » d'une dépendance à chaque exécution peut casser un mardi sans qu'une seule ligne de votre code ait changé.
Intégrer tests, sécurité et validations
Un bon pipeline place des contrôles à plusieurs endroits plutôt qu'un gros contrôle à la fin. Le tableau suivant reprend la logique de l'architecture de référence Azure Pipelines.
| Moment | Contrôles typiques |
|---|---|
| Pull request | Build, dépendances, linting, analyses statique et de sécurité, tests unitaires, revue |
| Après fusion | Tests d'intégration, publication des artefacts |
| Préproduction | Tests d'acceptation, validation manuelle éventuelle |
| Après production | Tests de fumée, surveillance |
Ce que recommande la CNIL
Si votre application traite des données personnelles, le pipeline fait partie de votre conformité. Le guide de la sécurité des données personnelles 2024 de la CNIL recommande des tests unitaires, d'intégration, fonctionnels et de sécurité avant une mise à disposition ou une mise à jour, dans un environnement distinct de la production. Il recommande aussi :
- des données fictives ou anonymisées pour les tests ;
- aucun secret dans les dépôts Git ou SVN ;
- un changement des secrets au passage en production ;
- une revue de code ou un test de non-régression avant la production.
La CNIL demande par ailleurs, sur sa page Encadrer les développements informatiques, d'intégrer la protection des données et la sécurité dès la conception et dans les configurations par défaut, plutôt qu'après le développement. Pour les applications mobiles, elle recommande une méthodologie CI/CD afin de permettre des mises à jour fréquentes, notamment de sécurité, avec une chaîne d'approvisionnement sécurisée. Nous détaillons cette logique dans notre guide sur le privacy by design.
Valider avant la production
Le pipeline peut imposer une porte humaine. Sur GitHub Actions, les règles de protection d'un environnement peuvent exiger une approbation manuelle, retarder un travail ou limiter l'environnement à certaines branches. Des réviseurs obligatoires peuvent être associés à un environnement protégé, et un seul réviseur requis suffit pour que le job se poursuive.
Protéger le pipeline lui-même
Un pipeline détient du code et des identifiants de production : c'est une cible de choix. JetBrains recommande de ne pas stocker les secrets dans le code source, d'utiliser un gestionnaire de secrets, de rechercher les vulnérabilités des dépendances et d'appliquer le moindre privilège. Concrètement : un compte de déploiement qui ne peut déployer que cette application, des secrets injectés à l'exécution, un contrôle automatique des dépendances à chaque exécution.
Notre point de vue : le pipeline suit le projet, pas l'inverse
Nous voyons souvent deux erreurs opposées. La première : un projet livré sans aucun pipeline, où la mise en ligne repose sur une seule personne et une procédure orale. La seconde : une usine à gaz copiée d'un grand éditeur, avec dix étapes, trois environnements et des outils que l'équipe ne maîtrise pas.
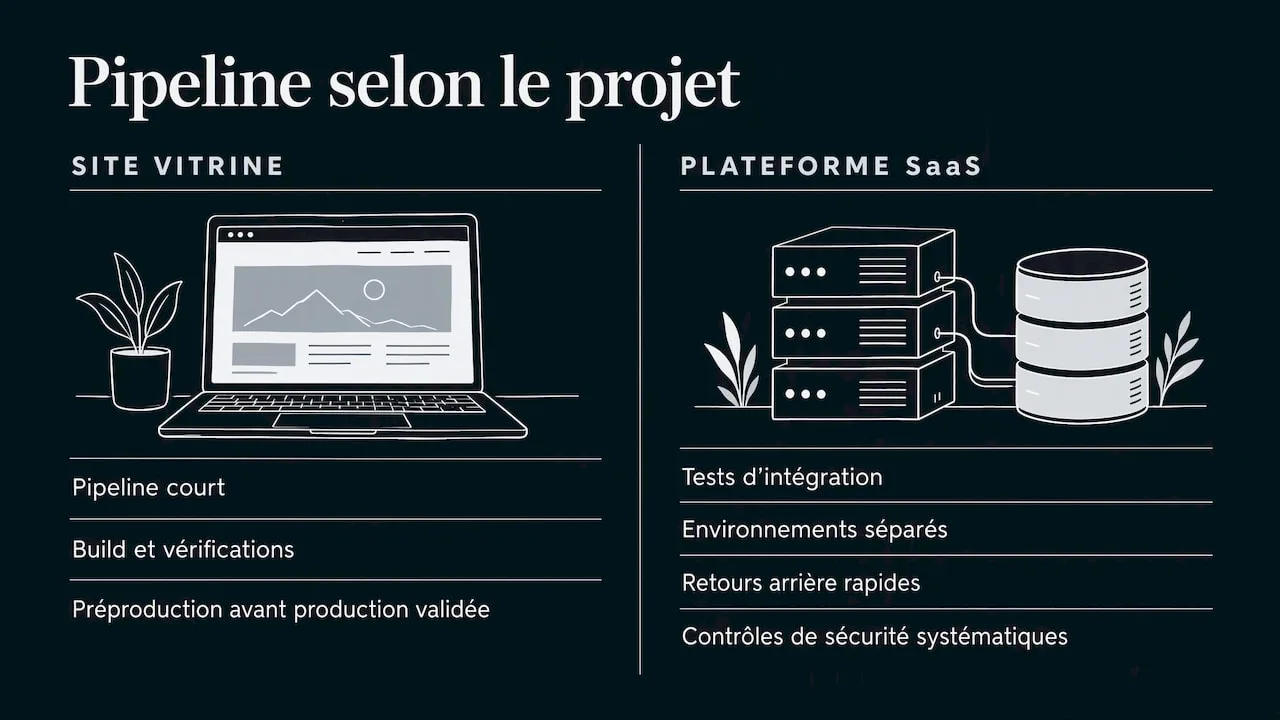
Notre approche est de dimensionner le pipeline à l'activité du client plutôt qu'à une technologie préétablie. C'est la même logique que notre méthodologie en quatre étapes : un interlocuteur unique, une communication transparente, et des choix expliqués. Pour un site vitrine, un pipeline court (build, vérifications, déploiement en préproduction puis en production après validation) suffit amplement. Pour une plateforme SaaS avec des données clients, nous ajoutons des tests d'intégration, des environnements séparés, des retours arrière rapides et des contrôles de sécurité systématiques.
Notre conviction : un pipeline vaut ce que vaut sa maintenance. Un pipeline abandonné, aux dépendances obsolètes et aux secrets jamais renouvelés, est pire que pas de pipeline, parce qu'il donne une fausse impression de contrôle. C'est pourquoi nous lions la livraison et la maintenance dans un même accompagnement.
— Riadh
Démarrer un pipeline CI/CD pas à pas
La démarche recommandée par GitLab est progressive : projet pilote simple, code sous contrôle de version, quelques tests automatisés, pipeline basique, puis enrichissement par des contrôles de qualité, de sécurité et de déploiement. Voici comment l'appliquer.
- Choisir un projet pilote. Une application modeste, avec une équipe qui a envie d'essayer, et pas votre système le plus critique.
- Tout versionner. JetBrains recommande de versionner le code, les fichiers de configuration, les scripts et les dépendances, puis de déclencher les tests automatisés à chaque commit.
- Écrire les premiers tests. Peu, mais fiables : un test qui échoue au hasard est vite ignoré, et le pipeline avec lui.
- Créer un pipeline minimal. Build, tests, publication d'un artefact. Rien d'autre au début.
- Ajouter la préproduction. Un environnement proche de la production, déployé automatiquement.
- Brancher la sécurité. Analyse des dépendances, détection de secrets, gestionnaire de secrets.
- Mesurer et optimiser. Durée du pipeline, taux d'échec, temps de retour arrière. Rapprochez l'environnement de test de la production, automatisez les tests d'acceptation et suivez l'avancement des sorties de versions.
Les pièges fréquents
- Un pipeline trop lent. Au-delà de quelques minutes sur les contrôles de pull request, on contourne.
- Des environnements qui divergent. Les bugs « qui n'arrivent qu'en production » viennent presque toujours de là.
- Des secrets dans le dépôt. Même supprimés, ils restent dans l'historique et doivent être renouvelés.
- Aucun plan de retour arrière. Décidez avant la mise en production comment revenir en arrière, pas pendant l'incident.
Mettre en place un pipeline avec NGL Studio
Nous concevons des applications web, des plateformes SaaS, des applications mobiles et des logiciels métier sur mesure, et le pipeline fait partie de la livraison : il est pensé avec l'application, pas ajouté en urgence après coup. Une fois l'outil en ligne, notre offre de maintenance et sécurité garde le pipeline, les dépendances et les accès en bon état. Si vous construisez un produit en ligne, découvrez nos applications web et SaaS.
Vous avez une application existante sans processus de livraison clair, ou un projet à lancer ? Décrivez-nous votre besoin depuis notre page d'accueil et nous vous répondrons avec un devis adapté à votre activité.
Questions fréquentes
Quelle est la différence entre CI et CD ?
La CI, intégration continue, consiste à fusionner fréquemment le code et à vérifier automatiquement sa qualité. Le CD désigne soit la livraison continue, où la publication est automatisée mais peut garder une approbation, soit le déploiement continu, où tout changement validé part en production sans approbation. Les deux se complètent dans le même pipeline.
Faut-il un déploiement continu pour tous les projets ?
Non. Le déploiement continu suppose une bonne couverture de tests et une capacité à revenir en arrière vite. Pour un outil métier où une erreur coûte cher, une livraison continue avec une validation avant la production est souvent plus raisonnable.
Le déploiement bleu-vert est-il adapté à une petite application ?
Oui, si l'application peut tourner en double temporairement et si les migrations de données sont conçues pour être compatibles entre deux versions. Le surcoût d'un second environnement est temporaire, mais la complexité des migrations demande une vraie conception.
Comment sécuriser les secrets dans un pipeline ?
Ne les stockez jamais dans le dépôt de code : utilisez un gestionnaire de secrets et appliquez le moindre privilège, comme le recommande JetBrains. La CNIL recommande en outre de changer les secrets au passage en production.
Sources
- Un pipeline de CI/CD, qu'est-ce que c'est ? (Red Hat)
- Architecture de base d'Azure Pipelines (Microsoft)
- Comprendre le CI/CD (AWS)
- Qu'est-ce qu'un pipeline CI/CD ? (GitLab)
- CI/CD pour microservices (Microsoft)
- Pipeline CI/CD de microservices sur Kubernetes (Microsoft)
- Approche CI/CD : notre guide complet (GitLab)
- Mise à niveau vers une nouvelle version de .NET (Microsoft)
- Guide de la sécurité des données personnelles 2024 (CNIL)
- Sécurité : encadrer les développements informatiques (CNIL)
- Sécurité : applications mobiles, conception et développement (CNIL)
- Déploiements et environnements (GitHub)
- Bonnes pratiques pour un CI/CD réussi (JetBrains TeamCity)