Le monitoring applicatif, aussi appelé supervision applicative ou APM (Application Performance Monitoring), consiste à observer en continu une application pour savoir si elle fonctionne, à quelle vitesse, avec quelles erreurs et pour quels utilisateurs. Il repose sur la collecte de données de télémétrie, selon Google Cloud, et vise à repérer un problème avant que vos clients ne vous l'annoncent. Voici ce qu'il faut surveiller, comment cela fonctionne, quelles métriques retenir, quels outils existent et quelles règles s'appliquent en France.
En bref
- Le monitoring ne se limite pas à savoir si l'application est en ligne : il suit aussi sa rapidité, ses erreurs, ses dépendances et l'expérience réelle des utilisateurs.
- Trois techniques se complètent : les tests synthétiques (des parcours simulés), l'observation des utilisateurs réels et le traçage des requêtes dans le code.
- Cinq ou six indicateurs bien choisis valent mieux qu'un tableau de bord de cinquante courbes : temps de réponse, taux d'erreur, débit, ressources et un indicateur métier.
- En France, les logs sont encadrés par la CNIL : durée de conservation, finalité limitée, aucun mot de passe enregistré.
- Le mieux est de penser le monitoring dès la conception de l'application, pas après la première panne.
Table des matières
- Ce que surveille réellement le monitoring applicatif
- Comment fonctionne la supervision, des tests aux alertes
- Monitoring, APM, observabilité : quelles différences ?
- Quelles métriques suivre
- Les bénéfices pour l'entreprise
- Outils gratuits et open source : que peut-on en attendre ?
- Sécurité et données personnelles : les règles à connaître en France
- Notre point de vue : le monitoring se conçoit avec l'application
- Mettre en place un monitoring en cinq étapes
- Faire concevoir et suivre sa supervision par NGL Studio
- Questions fréquentes
- Sources
Ce que surveille réellement le monitoring applicatif
Une idée reçue : superviser, ce serait pinger un site toutes les minutes. C'est utile, mais insuffisant. Une application peut répondre techniquement tout en étant inutilisable parce qu'elle est trop lente, et il faut alors examiner son environnement technique pour trouver la cause.
Concrètement, la surveillance couvre deux grands ensembles, d'après IBM :
- la pile applicative : frameworks, système d'exploitation, bases de données, API, middleware, serveurs web et interface utilisateur ;
- l'infrastructure : processeur, mémoire, disque et réseau.
S'y ajoute la sécurité. Toujours selon IBM, la surveillance de sécurité sert à détecter vulnérabilités, menaces et tentatives d'accès non autorisées. Pour une application métier qui manipule des données clients, c'est un volet à part entière, pas une option.
Les dépendances, première source de surprises
Une application moderne appelle rarement un seul serveur. Elle interroge une base de données, une API de paiement, un service d'envoi d'e-mails, un fournisseur d'authentification. Quand l'un d'eux ralentit, votre application ralentit, alors que votre code n'a pas changé. C'est pour cela que l'APM met en relation les performances de l'application avec son code, son infrastructure, ses bases de données et ses autres dépendances, afin de localiser les goulots d'étranglement.
Comment fonctionne la supervision, des tests aux alertes
Le principe : on instrumente l'application pour qu'elle émette des traces, des métriques et des logs. Autour de ces données, trois techniques se complètent : le traçage distribué suit les requêtes, le RUM observe les utilisateurs réels et le monitoring synthétique simule leurs parcours.
Le monitoring synthétique : tester avant que l'utilisateur ne passe
Des scénarios automatisés tournent à intervalle régulier : ouvrir la page de connexion, saisir un identifiant et un mot de passe, valider. Ils sont exécutés depuis plusieurs points de contrôle et déclenchent une alerte si un contenu manque ou si la réponse échoue ou tarde. L'intérêt : vous détectez une panne à 3 h du matin, un dimanche, sans attendre qu'un client écrive au support.
Les parcours à simuler en priorité sont ceux qui rapportent ou qui bloquent : connexion, recherche, ajout au panier, paiement, envoi d'un formulaire de devis.
L'observation des utilisateurs réels (RUM)
Le test synthétique vous dit que le parcours fonctionne dans des conditions idéales. Le RUM, lui, mesure ce que vivent vos vrais utilisateurs : un smartphone ancien, une connexion 4G faible, un navigateur inhabituel. Pour une application mobile, c'est décisif : un plantage propre à un modèle de téléphone ne se voit nulle part ailleurs.
Le traçage distribué
Quand un écran met huit secondes à s'afficher, le traçage montre où ces huit secondes sont passées : trois dans la base de données, quatre dans une API externe, une dans votre code. Ce suivi des transactions et des appels entre composants est ce qui distingue l'APM d'une simple vérification de disponibilité.
Avant la mise en ligne aussi
L'APM ne sert pas qu'en production. Il peut être déployé en phase de test pour analyser du trafic synthétique, découvrir des limites et identifier des erreurs avant la mise en ligne. Un test de charge avant une campagne commerciale évite bien des mauvaises surprises.
Les alertes : le point où tout se joue
Collecter des données ne sert à rien si personne n'est prévenu au bon moment. Quelques règles de bon sens :
- Alerter sur les symptômes, pas sur chaque cause possible : « le paiement échoue » plutôt que « le processeur dépasse 70 % pendant deux minutes ».
- Définir qui est prévenu et comment : une alerte critique doit atteindre une personne identifiée, pas une boîte partagée que personne ne lit.
- Éviter la fatigue d'alertes : si vingt notifications par jour sont ignorées, la vingt et unième, la vraie, le sera aussi.
- Documenter la réaction : chaque alerte renvoie à une courte procédure (quoi vérifier, qui appeler).
Monitoring, APM, observabilité : quelles différences ?
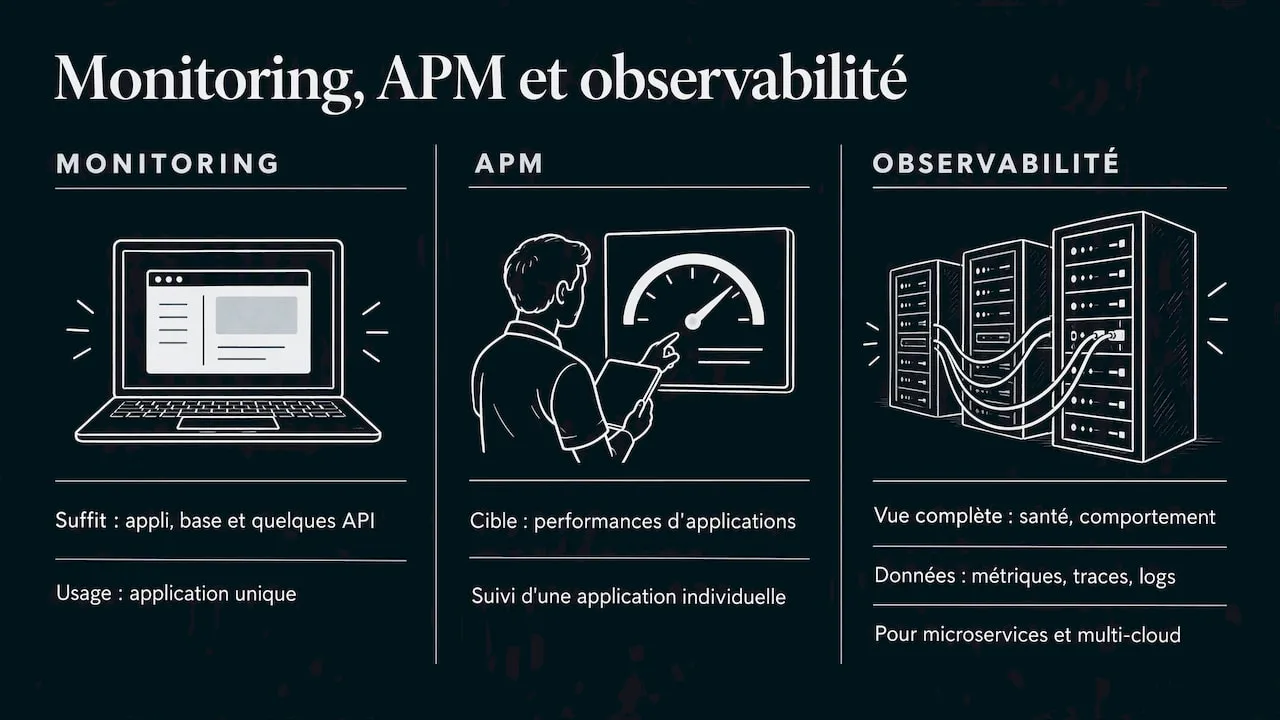
Les trois termes se recoupent, avec des nuances. L'APM se concentre sur le suivi et l'amélioration des performances d'applications individuelles, tandis que l'observabilité offre une vue plus complète de la santé et du comportement des applications. L'observabilité s'appuie sur la collecte et l'analyse des métriques, traces et logs.
Pour une application unique avec une base de données et quelques API, un bon monitoring applicatif suffit. L'observabilité prend tout son sens avec des architectures dynamiques, des microservices et des environnements multi-cloud, où l'on ne peut plus prévoir à l'avance toutes les questions qu'on aura à poser aux données.
Quelles métriques suivre
Le piège classique est de tout mesurer. Voici les indicateurs qui reviennent systématiquement, d'après IBM : utilisation du processeur, taux d'erreur, temps de réponse, taux de requêtes et retours sur l'expérience utilisateur. New Relic ajoute la latence, le débit, l'utilisation de la mémoire et des métriques métier comme les transactions, le chiffre d'affaires ou le taux de conversion.
| Indicateur | Ce qu'il raconte | Exemple de question à laquelle il répond |
|---|---|---|
| Temps de réponse | La rapidité perçue | Mes pages s'affichent-elles en un temps acceptable ? |
| Taux d'erreur | La fiabilité | Quelle part des requêtes échoue après la dernière mise en production ? |
| Débit (requêtes par seconde) | La charge | L'application tiendra-t-elle le pic du lundi matin ? |
| Processeur et mémoire | La marge de l'infrastructure | Dois-je dimensionner le serveur autrement ? |
| Indicateur métier | La valeur produite | Les commandes passent-elles aussi souvent que d'habitude ? |
La dernière ligne est souvent la plus parlante pour un dirigeant. Un serveur au repos et zéro commande en une heure : seul l'indicateur métier le révèle. Sur ce sujet, notre article sur le product analytics pour un SaaS explique comment mesurer l'usage plutôt que le trafic.
Les bénéfices pour l'entreprise
Les bénéfices se rangent en quatre catégories.
- Résoudre en proactif. L'APM aide à traiter les problèmes avant qu'ils ne touchent les clients, à réduire les temps d'arrêt et à suivre les engagements de niveau de service (SLA). Une stratégie d'APM peut faire passer les équipes d'une posture réactive à une posture proactive.
- Diagnostiquer vite. Un diagnostic rapide limite l'arrêt et libère du temps pour développer plutôt que corriger.
- Améliorer l'expérience utilisateur. Les lenteurs repérées tôt se corrigent avant de coûter des clients.
- Décider avec des données. Dimensionnement, priorités de développement, arbitrages budgétaires : on s'appuie sur des mesures plutôt que sur des impressions.
Pour un prestataire, le monitoring sert aussi à prouver : un engagement de disponibilité n'a de valeur que s'il est mesuré.
Outils gratuits et open source : que peut-on en attendre ?
Des outils gratuits existent, et beaucoup d'équipes démarrent ainsi. Prometheus, par exemple, est un outil open source de monitoring et d'alerte qui collecte et stocke des métriques en séries temporelles, permet des requêtes en PromQL et génère des alertes. Il privilégie la fiabilité plutôt qu'une exactitude absolue, ce qui le rend inadapté à des usages comme la facturation à la requête, où chaque événement doit être compté exactement.
Les limites des solutions gratuites sont rarement techniques, elles sont humaines :
- il faut les installer, les héberger et les mettre à jour ;
- il faut écrire les tableaux de bord et les règles d'alerte ;
- quelqu'un doit réagir quand l'alerte sonne.
Les solutions hébergées déplacent ce travail vers un abonnement, avec une facturation généralement liée au volume de données. Le bon choix dépend moins de l'outil que de votre capacité à l'exploiter. Une PME sans équipe technique interne gagnera à confier la mise en place et le suivi à son prestataire.
Sécurité et données personnelles : les règles à connaître en France
Surveiller une application, c'est produire des logs, et ces logs contiennent parfois des données personnelles : adresses IP, identifiants, actions des utilisateurs. La CNIL cadre le sujet dans sa fiche Tracer les opérations :
- conserver les logs entre six mois et un an, sauf exceptions ;
- informer les utilisateurs, après information et consultation des instances représentatives du personnel lorsqu'il s'agit de salariés ;
- limiter l'usage des logs au bon fonctionnement du système informatique ;
- ne jamais enregistrer les mots de passe ni leur hash.
La CNIL recommande aussi de journaliser les activités métier, les interventions techniques, les anomalies et les événements de sécurité, pour détecter les accès frauduleux et retrouver l'origine d'un incident. Côté accès, elle préconise des identifiants uniques, une authentification avant tout accès aux données personnelles et des politiques d'accès différenciées dès la conception. Appliquez la même logique à vos outils de monitoring : tout le monde n'a pas à voir tous les logs.
Si votre site recueille aussi des traceurs de mesure d'audience, consultez notre point sur le bandeau cookies RGPD. En cas de doute sur la durée de conservation ou la base légale de vos logs, rapprochez-vous de votre délégué à la protection des données ou d'un juriste spécialisé.
Notre point de vue : le monitoring se conçoit avec l'application
Nous voyons souvent le monitoring arriver après la première panne, une fois que l'application est livrée, que l'équipe projet est passée à autre chose et que personne ne sait vraiment où regarder. C'est le pire moment pour s'en occuper.
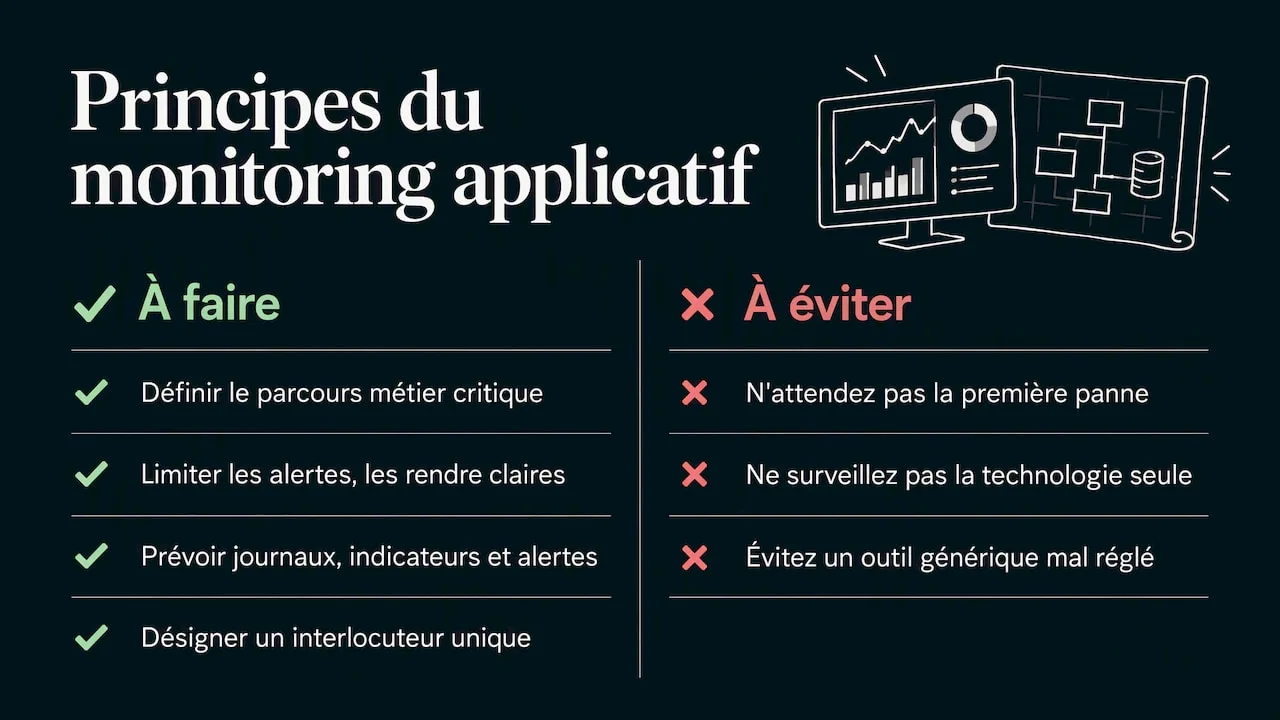
Notre conviction tient en trois points. D'abord, on ne supervise pas une technologie, on supervise une activité : avant de choisir un outil, nous demandons au client quel parcours ne doit jamais tomber (la prise de commande, la saisie d'un dossier, l'accès à l'espace client). Ensuite, un outil générique mal réglé produit du bruit, et le bruit finit ignoré : mieux vaut peu d'alertes, claires, qu'un tableau de bord impressionnant. Enfin, le monitoring a besoin d'un interlocuteur unique qui connaît l'application, ses dépendances et son historique, c'est ce que notre méthode en quatre étapes cherche à garantir du début à la fin du projet.
Concrètement, cela veut dire prévoir les journaux utiles, les indicateurs métier et les alertes dès la conception, puis les faire vivre avec la maintenance.
— Riadh
Mettre en place un monitoring en cinq étapes
- Lister les parcours critiques. Trois à cinq maximum, formulés en termes d'activité : « un client peut payer », « un collaborateur peut valider une demande ».
- Choisir les indicateurs. Temps de réponse, taux d'erreur, débit, ressources, plus un indicateur métier par parcours.
- Instrumenter l'application. Logs structurés, métriques, traces, sans y glisser de données sensibles.
- Configurer tests et alertes. Un scénario synthétique par parcours critique, des seuils réalistes, un responsable désigné.
- Revoir régulièrement. Après chaque évolution majeure, vérifier que les seuils, les parcours et les accès sont toujours pertinents.
Pour une application mobile, ajoutez le suivi des plantages et des versions du système d'exploitation les plus utilisées parmi vos utilisateurs.
Faire concevoir et suivre sa supervision par NGL Studio
NGL Studio conçoit des applications web, mobiles, des logiciels métier et des outils d'IA sur mesure pour les entreprises, avec un interlocuteur unique et une méthode en quatre étapes. Nous intégrons la supervision dans les projets de applications web et SaaS et prolongeons le suivi avec notre offre de maintenance et sécurité. Vous avez déjà une application qui vous inquiète, ou un projet à cadrer ? Décrivez-nous votre besoin, nous vous répondrons par un devis adapté.
Vous pouvez aussi parcourir l'ensemble de nos services pour voir ce qui correspond à votre situation.
Questions fréquentes
Quelle est la différence entre supervision et monitoring applicatif ?
Dans l'usage courant, les deux termes désignent la même chose : surveiller le fonctionnement d'une application. Le mot « monitoring » vient de l'anglais et domine dans les équipes techniques, « supervision » est plus fréquent dans les services informatiques et l'infogérance. L'important est le périmètre : disponibilité seule, ou aussi performances, erreurs et expérience utilisateur.
Existe-t-il un outil de monitoring gratuit ?
Oui. Prometheus, par exemple, est un outil open source qui collecte des métriques et déclenche des alertes. Le logiciel est gratuit, mais son installation, son hébergement et son exploitation ont un coût en temps. Pour une petite équipe sans compétences dédiées, une solution hébergée ou un accompagnement par un prestataire est souvent plus réaliste.
Faut-il surveiller une application mobile différemment d'une application web ?
Les principes sont les mêmes, mais les points de vigilance changent. Sur mobile, vous suivez en plus les plantages, les versions du système, les modèles d'appareils et la qualité de la connexion des utilisateurs. L'observation des utilisateurs réels y est particulièrement utile, car vos tests en laboratoire ne reproduiront jamais toute la diversité du parc de téléphones.
Combien de temps faut-il conserver les logs en France ?
La CNIL recommande une conservation de six mois à un an, sauf exceptions, avec un usage limité au bon fonctionnement du système informatique. Les mots de passe et leur hash ne doivent pas figurer dans les logs. Pour votre cas précis, appuyez-vous sur la fiche de la CNIL et sur votre délégué à la protection des données.
Le monitoring est-il utile pour une petite application ?
Oui, et il peut rester très simple : un test synthétique sur le parcours principal, un suivi du taux d'erreur et une alerte vers une personne identifiée. L'investissement est faible comparé au coût d'une panne découverte par vos clients. Le dispositif peut grandir avec l'application.
Sources
- Google Cloud : qu'est-ce que l'APM
- IBM : bonnes pratiques pour la surveillance des applications
- Elastic : qu'est-ce que l'APM
- OTO Services : supervision applicative
- ServicePilot : observabilité des applications
- AWS : qu'est-ce que l'APM
- Uptrends : surveillance des applications web
- TechTarget : guide de l'APM
- New Relic : monitoring des applications
- Splunk : l'Application Performance Monitoring
- Prometheus : présentation
- CNIL : tracer les opérations
- CNIL : gérer les utilisateurs